 The Business Plus บิสิเนสพลัส
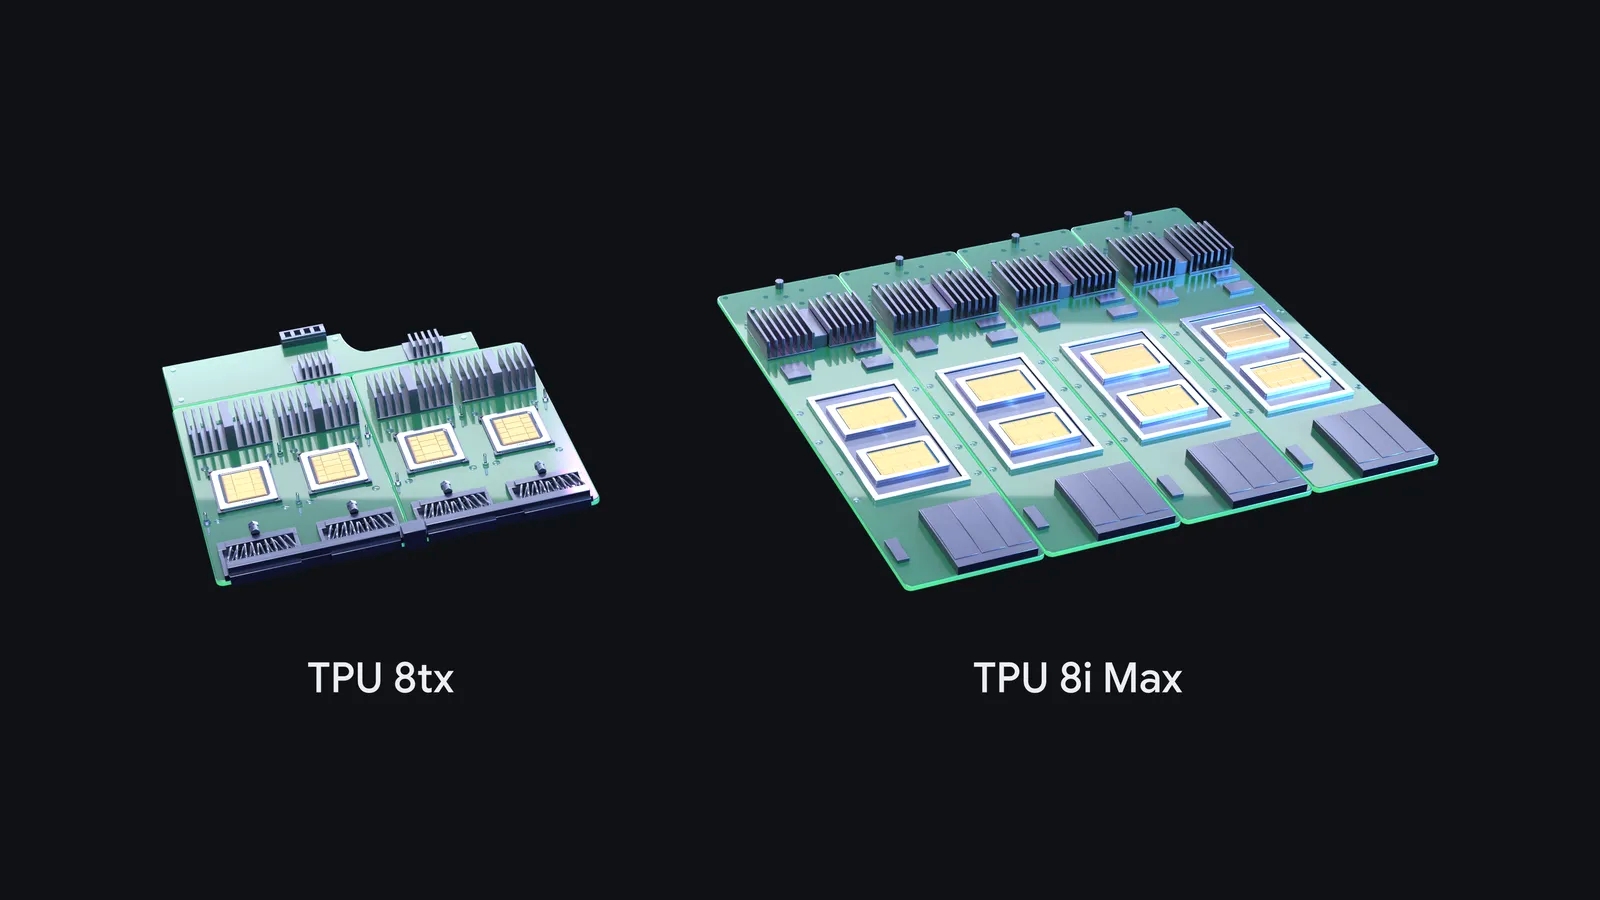
Google ประกาศขยายพอร์ตโฟลิโอชิป TPU เจเนอเรชันที่ 8 ด้วยการเปิดตัวระบบประมวลผลเพิ่มเติมอีก 2 รุ่น ได้แก่ TPU 8i Max และ TPU 8tx ซึ่งได้รับการออกแบบมาเพื่อรองรับงาน AI ที่ต้องการความปลอดภัยและการประมวลผลข้อมูลที่มีบริบทซับซ้อน โดยแต่ละระบบมุ่งรองรับการทำงานในขั้นตอนที่แตกต่างกันของวงจรการพัฒนาและใช้งาน AI ซึ่งถือเป็นครั้งแรกที่ Google เปิดตัว TPU ถึง 4 รูปแบบภายในปีเดียว
Google นำ TPU มาใช้งานในหลากหลายด้าน ไม่ว่าจะเป็นการฝึกฝนและให้บริการโมเดล Gemini ของ Google เอง การรองรับเวิร์กโหลดของระบบ Agent ตลอดจนการให้บริการลูกค้า Google Cloud ผ่านโครงสร้างพื้นฐานคลาวด์ของบริษัท นอกจากนี้ จากความสนใจและความต้องการใช้งานที่เพิ่มขึ้นในช่วงที่ผ่านมา Google ยังเปิดให้ลูกค้าสามารถนำ TPU ไปติดตั้งและใช้งานได้โดยตรงภายในดาต้าเซ็นเตอร์ของตนเอง ส่งผลให้ธุรกิจ TPU เติบโตอย่างก้าวกระโดด โดยปัจจุบันมีลูกค้าเกือบ 100 ราย ครอบคลุมตั้งแต่บริษัทวิจัย AI ชั้นนำ บริษัทด้านการซื้อขายหลักทรัพย์ ธุรกิจค้าปลีก ไปจนถึงมหาวิทยาลัย และองค์กรอื่น ๆ อีกมากมาย
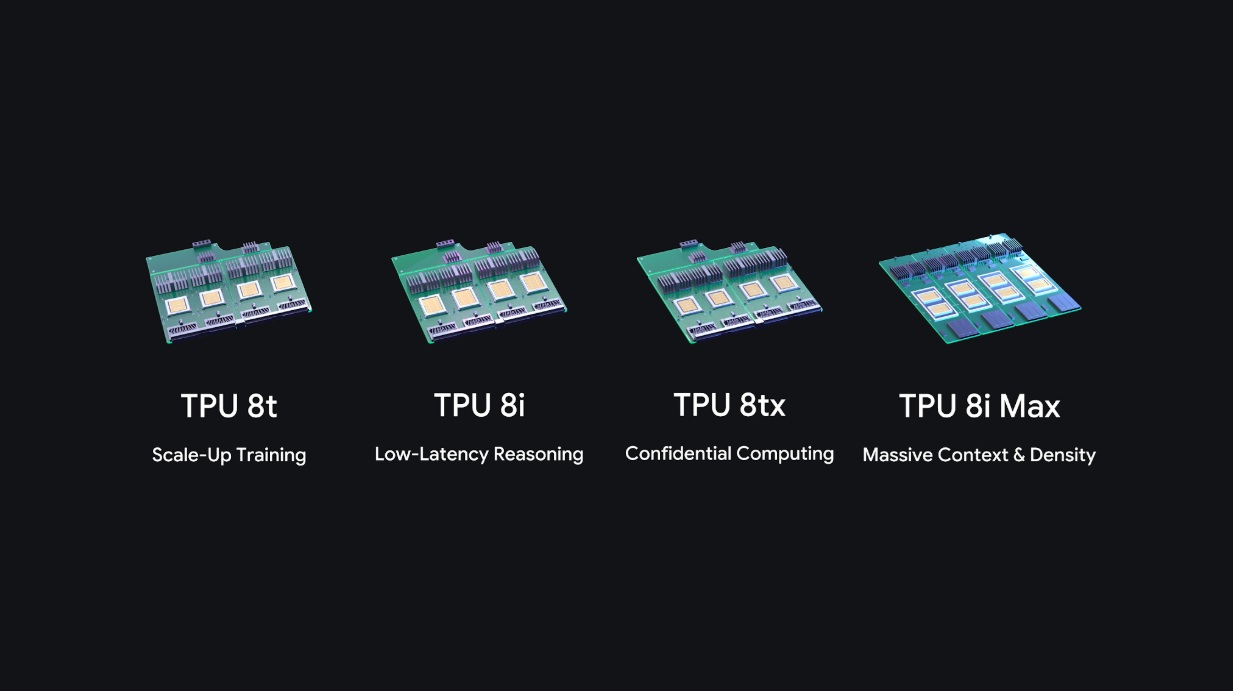
หลังจากเปิดตัวครั้งแรกในงาน Cloud Next เมื่อเดือนเมษายนที่ผ่านมา ชิป TPU 8t และ TPU 8i ถือเป็นมาตรฐานใหม่ของชิปในเจเนอเรชันนี้ โดยมีประสิทธิภาพในการเทรนโมเดลสูงขึ้นถึง 2.7 เท่า พร้อมความคุ้มค่าต่อราคาในการประมวลผลที่ดีขึ้น 80% เมื่อเทียบกับ TPU รุ่นก่อนหน้า โดย TPU 8t ได้รับการออกแบบให้เป็นขุมพลังสำหรับการเทรนโมเดลพื้นฐานขนาดใหญ่ โดยมุ่งเพิ่ม “Goodput” หรือปริมาณผลลัพธ์จากการประมวลผลที่เป็นประโยชน์ให้ได้สูงสุดต่อพลังงานที่ใช้หนึ่งวัตต์ ส่วน TPU 8i ทำหน้าที่เป็นหน่วยประมวลผลด้านการให้เหตุผลที่ออกแบบมาเพื่อก้าวข้ามข้อจำกัดด้านหน่วยความจำ พร้อมลดความล่าช้าในการสื่อสารระหว่างชิปลงได้สูงสุดถึงครึ่งหนึ่ง ขณะเดียวกัน เมื่อองค์กรต่าง ๆ เริ่มนำ Agent อัตโนมัติมาใช้งานจริง Google จึงพัฒนาระบบประมวลผลเพิ่มเติมอีก 2 รูปแบบจากสถาปัตยกรรมพื้นฐานเดิม ได้แก่ TPU 8i Max และ TPU 8tx เพื่อรองรับความท้าทายเร่งด่วน 2 ประการ ได้แก่ การรักษาความปลอดภัยของข้อมูลในระดับฮาร์ดแวร์ และการรองรับบริบทการประมวลผลขนาดใหญ่ระดับล้านโทเค็น
Amin Vahdat ประธานเจ้าหน้าที่ฝ่ายเทคโนโลยีและรองประธานอาวุโสฝ่าย AI และโครงสร้างพื้นฐานของ Google กล่าวว่า “เมื่อการประมวลผลกำลังเปลี่ยนจากการรองรับการทำงานของมนุษย์ไปสู่ยุคของ Agent ภาคธุรกิจจึงต้องการชิปประมวลผลความเร็วสูงที่สามารถรองรับการให้เหตุผลบนบริบทข้อมูลขนาดใหญ่ของโมเดล AI ได้อย่างมีประสิทธิภาพ ขณะเดียวกัน ลูกค้าบางกลุ่มในอุตสาหกรรมที่มีข้อกำหนดด้านกฎระเบียบสูงก็ต้องการเทคโนโลยีการเข้ารหัสเฉพาะทางเพื่อรองรับการใช้งานที่มีข้อกำหนดเฉพาะ ระบบ TPU รุ่นใหม่นี้พัฒนาขึ้นเพื่อตอบโจทย์ความต้องการดังกล่าว ควบคู่กับประกาศล่าสุดเกี่ยวกับ PyTorch ของเรา โดยมีเป้าหมายเพื่อให้นักพัฒนาและลูกค้าทุกกลุ่มเข้าถึง TPU ได้ง่ายยิ่งขึ้น การผสานชิปประมวลผลที่ออกแบบขึ้นเฉพาะและมีโครงสร้างแบบโมดูลาร์เข้ากับชุดซอฟต์แวร์แบบเปิดที่ใช้งานง่าย ช่วยให้เราสามารถพัฒนาฮาร์ดแวร์และรูปแบบระบบใหม่ ๆ ได้รวดเร็วทันต่อการเปลี่ยนแปลงของอุตสาหกรรม AI”
TPU 8tx ยกระดับความปลอดภัยขั้นสูง พร้อมเพิ่มขีดความสามารถการเทรนโมเดลขนาดเล็ก
TPU 8tx ออกแบบมาเพื่อรองรับองค์กรที่มีข้อกำหนดด้านกฎระเบียบสูงและหน่วยงานภาครัฐที่ใช้งานโมเดล AI ขั้นสูงหรือโมเดลเฉพาะขององค์กร รวมถึง Agent อัตโนมัติ ควบคู่กับการจัดการข้อมูลสำคัญที่ต้องได้รับการคุ้มครองเป็นพิเศษ
โดยทั่วไป ข้อมูลจะได้รับการเข้ารหัสทั้งในขณะจัดเก็บและระหว่างรับส่งผ่านเครือข่าย แต่จำเป็นต้องถอดรหัสในหน่วยความจำขณะที่ระบบกำลังประมวลผล TPU 8tx พัฒนาบนสถาปัตยกรรมชิปเดียวกับ TPU 8t และทำงานร่วมกับโฮสต์ CPU จาก AMD ที่ปรับแต่งเป็นพิเศษ โดยผสานระบบรักษาความปลอดภัยไว้ในระดับฮาร์ดแวร์ ช่วยปกป้องและแยกข้อมูลสำคัญ รวมถึงค่าน้ำหนักของโมเดล แม้ในระหว่างการประมวลผล นอกจากนี้ TPU 8tx ยังนำเครือข่าย Boardfly ที่มีความหน่วงต่ำ ซึ่งพัฒนาขึ้นเพื่อรองรับการให้เหตุผลแบบเรียลไทม์มาใช้งาน ทำให้ Agent ที่ทำงานหลายขั้นตอนประมวลผลได้อย่างต่อเนื่อง พร้อมลดความหน่วงลง 2 เท่า เมื่อเทียบกับ TPU 8t โดยแทบไม่ส่งผลกระทบต่อประสิทธิภาพโดยรวม
การผสานขีดความสามารถด้านการประมวลผลสำหรับการเทรนโมเดลเข้ากับโครงข่ายรับส่งข้อมูลความเร็วสูงสำหรับงานประมวลผล (Inference) ช่วยให้องค์กรสามารถใช้งานและปรับแต่งโมเดลได้พร้อมกันบนระบบเดียว โดย TPU 8tx รองรับทั้งการปรับแต่งโมเดลด้วยข้อมูลภายในองค์กร การถ่ายทอดความรู้จากโมเดลขนาดใหญ่ไปยังโมเดลขนาดเล็ก และการฝึก Agent ด้วยเทคนิคการเรียนรู้แบบเสริมกำลัง โดยไม่จำเป็นต้องย้ายข้อมูลสำคัญระหว่างคลัสเตอร์ที่แยกจากกัน
TPU 8i Max ขุมพลังใหม่ ทลายกำแพงข้อจำกัดด้านหน่วยความจำ
เมื่อ AI Agent หลายสิบตัวทำงานร่วมกันเพื่อจัดการโค้ดในระบบซอฟต์แวร์ขนาดใหญ่ หรือประมวลผลวิดีโอที่มีความยาวหลายชั่วโมงพร้อมกัน แบนด์วิดท์หน่วยความจำก็อาจกลายเป็นคอขวดที่ฉุดรั้งประสิทธิภาพการประมวลผลได้อย่างรวดเร็ว
TPU 8i Max เพิ่มขีดความสามารถด้านการประมวลผลและหน่วยความจำให้ทำงานสอดรับกัน โดยให้ประสิทธิภาพการประมวลผล หน่วยความจำ SRAM และแบนด์วิดท์ HBM เพิ่มขึ้นเป็น 2 เท่าเมื่อเทียบกับ TPU 8i ช่วยให้หน่วยประมวลผลเข้าถึงข้อมูลที่จำเป็นได้อย่างต่อเนื่อง รองรับการประมวลผลเวิร์กโหลดขนาดใหญ่แบบไม่สะดุด นอกจากนี้ TPU 8i Max ยังรองรับการติดตั้งชิปประมวลผลได้มากขึ้นถึง 2 เท่าภายในพื้นที่แร็กขนาดเดิม ช่วยให้ดาต้าเซ็นเตอร์เพิ่มขีดความสามารถในการประมวลผลได้มากขึ้นอย่างมีนัยสำคัญ โดยใช้พื้นที่ติดตั้งและพลังงานได้อย่างมีประสิทธิภาพยิ่งขึ้น
แม้ TPU แต่ละระบบจะรองรับเวิร์กโหลดได้หลากหลาย แต่เมื่อนำ TPU ทั้ง 4 ระบบจากเจเนอเรชันที่ 8 ของ Google มาใช้งานร่วมกัน จะช่วยให้ลูกค้ามีชิปประมวลผลความเร็วสูงที่ออกแบบมาเฉพาะสำหรับทุกขั้นตอนของการทำงานของ Agent โดย TPU 8t รองรับการเทรนโมเดลขนาดใหญ่ ส่วน TPU 8i เน้นการประมวลผลเพื่อการให้เหตุผลที่มีความหน่วงต่ำ ขณะที่ TPU 8tx รองรับการประมวลผลข้อมูลที่เป็นความลับ และ TPU 8i Max รองรับการประมวลผลข้อมูลที่มีบริบทขนาดใหญ่ พร้อมความหนาแน่นในการประมวลผลต่อแร็กสูงที่สุด
สามารถติดตามรายละเอียดเพิ่มเติมเกี่ยวกับระบบ TPU รุ่นใหม่ของ Google ได้ทาง Google In the News หรือรับชมผ่านการถ่ายทอดสด